هر شطرنجبازی که ساعتهایی را صرف تمرین در برابر رباتهای رایانهای کرده باشد، با آن حس ناخوشایند و نامأنوس روبهرو شده است. بیست حرکت صبورانه ساختار پیادهای مستحکمی میسازید، اسبهایتان را در خانههای امن مرکزی مستقر میکنید و ستونهای باز را با دقت زیر نظر میگیرید. ناگهان و بدون هیچ توجیه استراتژیک یا تاکتیکی، برنامه وزیرش را در ازای یک پیادهٔ ساده پیشکش میکند یا رخ فعال خود را به کنج صفحه میفرستد. تنها سه حرکت پس از این خطای حیرتآور، همان نرمافزار دوباره مانند ابررایانهای شکستناپذیر شروع به محاسبهٔ شاخههای پیچیده میکند.
این تناقض آشکار ناشی از کمبود توان پردازشی نرمافزارها نیست. برعکس، مسئله اینجاست که موتورهای سنتی مانند ماشین حساب فکر میکنند و درکی از روانشناسی صفحهٔ شطرنج ندارند. وقتی برنامهنویسان میکوشند موتوری قدرتمند را برای بازیکنان آماتور یا نوآموز هماهنگ کنند، تقریباً همیشه به تمهیدات مکانیکی نامناسبی متوسل میشوند. برنامه میلیونها وضعیت را در ثانیه بررسی میکند، بهترین شاخهٔ ریاضی را مییابد، و سپس عمداً خطاهایی تصادفی به بازی تزریق میکند تا ریتینگ خود را پایین بیاورد. این شیوه شاید در جدول اعداد نتیجه بدهد، اما هیچ شباهتی به ذهن و رفتار یک حریف واقعی ندارد.
در سال ۲۰۲۰ گروهی از پژوهشگران هوش مصنوعی و علوم داده تصمیم گرفتند این شکاف را با رویکردی تازه بررسی کنند. آنها بهجای اینکه از سامانه بخواهند با قدرت محض برنده شود، پرسشی بنیادین مطرح کردند: آیا یک شبکهٔ عصبی عمیق میتواند شطرنج را درست همانطور که انسانها بازی میکنند یاد بگیرد؟ حاصل این پژوهش پروژهٔ Maia Chess بود؛ موتوری متنباز که شیوهٔ بازی در برابر رایانه را دگرگون کرد. اگر به دنبال شطرنج آنلاین در برابر حریفی هستید که رفتارش منطقی و طبیعی باشد، شناخت سازوکار Maia نگاه شما را به تمرین شطرنج تغییر میدهد.
نقص ساختاری در رباتهای ضعیفشدهٔ سنتی
برای درک تفاوت Maia، باید سازوکار موتورهای رایجی مانند Stockfish را بررسی کرد. این موتورها درختهای جستوجوی بسیار عمیقی میسازند و هر وضعیت را با توابع دقیق ارزشگذاری مادی و پوزیسیونی میسنجند. ماشین خستگی نمیشناسد، اضطراب زمان ندارد، از کیشهای ناگهانی نمیترسد و تعصب خاصی به زیبایی طرحها نشان نمیدهد؛ الگوریتم تنها دهها نیمحرکت به جلو نگاه میکند تا مطمئن شود کدام تصمیم بیشترین برتری عینی را دارد.
سازندگان رباتها برای شبیهسازی حریفی در سطح ریتینگ ۱۱۰۰، ۱۲۰۰ یا ۱۵۰۰ معمولاً از دو روش استفاده میکنند:
- محدود کردن عمق محاسبه: مانع شدن از بررسی شاخهها فراتر از چند حرکت کوتاه.
- تزریق پارازیت تصادفی: مجبور ساختن الگوریتم به انتخاب حرکات ضعیفتر یا انجام اشتباهات فاحش بر پایهٔ شانس.
هر دو روش بازی را از ریخت میاندازند. یک شطرنجباز با ریتینگ ۱۲۰۰ یا ۱۵۰۰ به مدت پانزده حرکت شبیه استاد بزرگ بازی نمیکند تا بعد ناگهان به دستور یک گردونهٔ شانس رخش را تقدیم کند. انسانها به دلایل شناختی مشخصی دچار لغزش میشوند: تنگی وقت، خستگی ذهنی، پنهان ماندن تهدیدها در شلوغی صفحه یا نادیده گرفتن یک مهرهٔ آویزان. بازیکن آماتور شاید حرکتی بینابینی را نبیند، اما هیچگاه خانهٔ خود را بیدلیل ویران نمیکند.
تمرین با چنین موتورهایی فایدهٔ آموزشی اندکی دارد. اگر بهخاطر هدیه دادن تصادفی مهره پیروز شوید، چیزی دربارهٔ بهرهگیری از ضعفهای موقعیتی یاد نگرفتهاید؛ و اگر ربات ناگهان به خود بیاید و با ترکیب تاکتیکی هشتحرکتی شما را مات کند، تنها دلسرد میشوید.
آموزش Maia: پیشبینی رفتار انسان بهجای بیشینهسازی برد
پژوهشگران پروژهٔ Maia (شامل Reid McIlroy-Young و Siddhartha Sen و Jon Kleinberg و Ashton Anderson) دریافتند که همگامسازی هوش مصنوعی با رفتار انسان نیازمند دگرگونی در فلسفهٔ یادگیری است[1].
آنها بهجای یادگیری تقویتی از راه بازی با خود (رویکرد مشهور AlphaZero که در آن سامانه میلیونها بار با خود بازی میکند تا به کمالی مافوقبشری برسد)، Maia را با شیوهٔ یادگیری نظارتشده و بر اساس بازیهای واقعی شطرنجبازان در سرور Lichess آموزش دادند.
مجموعهٔ دادهها چشمگیر بود: پژوهشگران برای هر ردهٔ مهارتی ۱۲ میلیون بازی جمعآوری کردند و آنها را در دستههای مشخصی از ریتینگ ۱۱۰۰ تا ۱۹۰۰ جای دادند. هر مدل مستقل در خانوادهٔ Maia منحصراً روی بازیهایی آموزش دید که هر دو شرکتکننده در همان بازهٔ مهارتی قرار داشتند.
پژوهشگران حسابهای مشکوک، رباتهای خودکار و بازیهای سریع بدون تفکر را از پایگاه داده حذف کردند و تنها بازیهای باکیفیت استاندارد و سریع را برگزیدند. هدف شبکه یافتن بهترین حرکت ریاضی نبود؛ هدف این بود که با دیدن موقعیتی از یک بازی میان دو انسان، دقیقاً پیشبینی کند بازیکن در آن وضعیت چه حرکتی انجام داده است.
با تحلیل ۱۲ میلیون بازی در هر سطح، Maia اولویتهای استراتژیک، نقشههای طبیعی و خطاهای رایج بازیکنان را درونی کرد. مدل سطح ۱۵۰۰ مانند قهرمان جهان فکر نمیکند تا بعد حرکتی تصادفی را اجرا کند؛ بلکه صفحه را با چشم و درک یک بازیکن همسطح خود ارزیابی میکند.
دقت پیشبینی حرکت: برتری آشکار Maia بر Stockfish
تفاوت میان بهینهسازی برای پیروزی و تقلید از ذهن انسان هنگام سنجش دقت پیشبینی حرکات کاملاً آشکار میشود. در آزمونهای پژوهش سال ۲۰۲۰، پژوهشگران بررسی کردند که موتورهای گوناگون با چه بسامدی حرکت برگزیدهٔ انسان را درست حدس میزنند.
موتورهای سنتی در این آزمون نتایج ضعیفی گرفتند. حتی در عمقهای کم، Stockfish در کمتر از ۴۰٪ موارد موفق به پیشبینی تصمیم انسان شد و میانگین آن حدود ۳۸٪ بود. جالب اینکه هرچه عمق محاسبهٔ Stockfish افزایش مییافت، هماهنگی آن با رفتار انسان کمتر میشد؛ زیرا شاخههای طولانی آن را به ریزهکاریهای تاکتیکی دور از ذهن آماتورها میکشاند.
در نقطهٔ مقابل، مدلهای Maia در تمام ردههای ریتینگ از مرز ۵۰٪ دقت گذشتند. در ردههای متوسط، Maia در ۵۲٪ تا ۵۴٪ موارد دقیقاً همان حرکتی را پیشبینی کرد که شطرنجباز روی صفحه پیاده کرده بود. حتی در ردهٔ آغازین ۱۱۰۰ ریتینگ، این دقت به ۴۸٪ رسید.
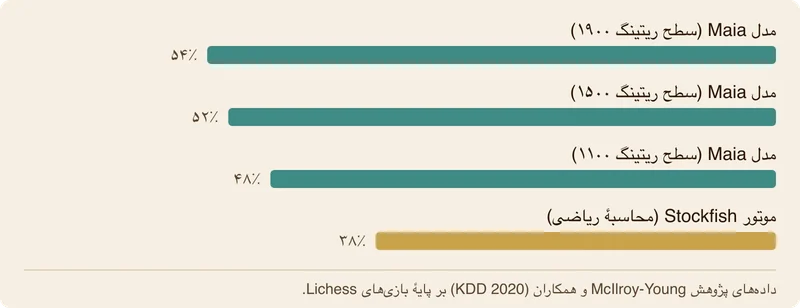
این برتری نشان میدهد تصمیمات شطرنجبازان آشفته نیست. انسانها به الگوهای تصویری، امنیت شاه، همکاری مهرهها و ساختارهای آشنا تکیه میکنند. چون Maia بر پایهٔ تصمیمات زیستهٔ واقعی شکل گرفته، پیشنهادهایش بازتاب تفکر یک حریف زنده است.
موتور حتی اشتباهات شایع را هم بهخوبی پیشبینی میکند. اگر در موقعیتی فریبی آشکار وجود داشته باشد که بازیکنان سطح ۱۲۰۰ در آن میافتند، Maia نیز به همان سمت گرایش پیدا میکند؛ ویژگی ارزشمندی که آن را به حریفی کمنظیر برای تمرین تبدیل میسازد.
منطق پوزیسیونی و الگوهای تاکتیکی طبیعی
هنگامی که بازیهای یک مدل انسانمحور را بررسی میکنید یا این ایدههای پوزیسیونی را هنگام بازی شطرنج آنلاین به کار میگیرید، جریان بازی از همان دقایق نخست پیوسته و معنادار پیش میرود. در گشایش و اوایل بازی وسط، Maia مهرههای خود را بر پایهٔ طرحهایی سنجیده گسترش میدهد.
برای نمونه گشایش کلاسیکی مانند بازی ایتالیایی را در نظر بگیرید. Maia بهجای رفتن به سراغ شاخههای فرعی پرخطر که نیازمند محاسبات خارقالعاده برای حفظ تعادل هستند، مهرههای سبک را به مرکز میآورد، شاه را قلعه میبرد و پیادهها را هماهنگ میسازد.
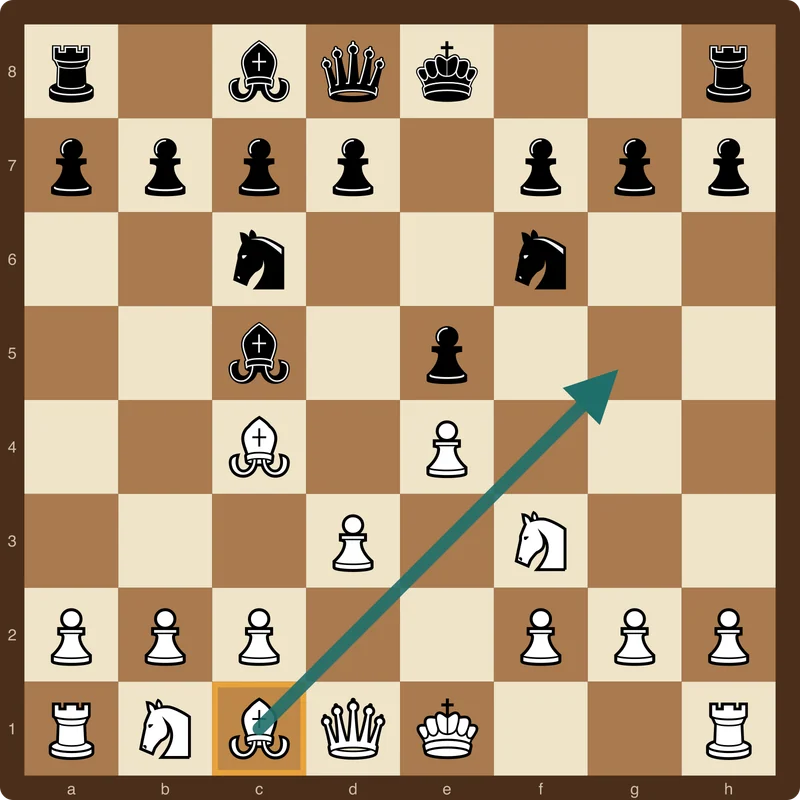
در این فضا هر بازیکن باشگاهی به فکر سنجاق کردن اسب حریف روی خانهٔ f6 یا پشتیبانی از مرکز است. Maia همین تصمیمات شهودی را ترجیح میدهد و دست به راندنهای بیدلیل پیادههای کناری نمیزند.
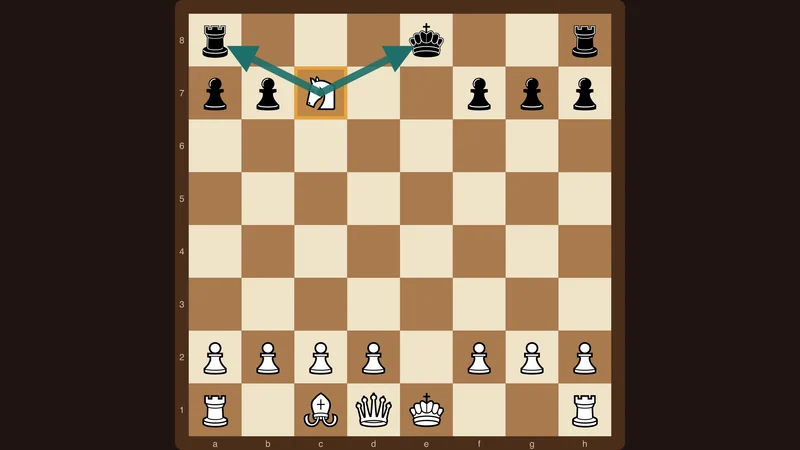
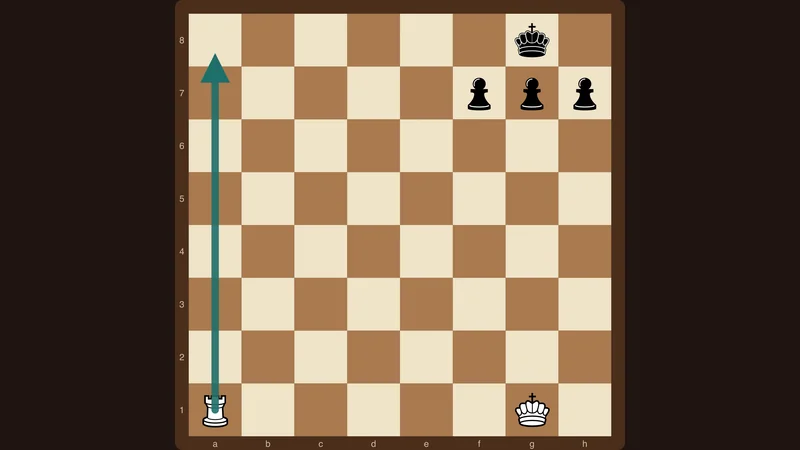
این ویژگی در موقعیتهای حساس تاکتیکی نیز مشهود است. بازیکنان آماتور مرتباً درگیر موتیفهایی چون چنگال، آچمز و سیخ در شطرنج میشوند یا با غفلت از عرض آخر به دام مات عرض آخر در شطرنج میافتند. وقتی Maia فرصتی را از دست میدهد، خطایش دلیلی انسانی دارد: پنهان بودن مهره پشت ساختار پیادهای، شلوغی بیش از حد صفحه یا نیاز به حرکتی آرام و نامنتظره.
بررسی چنین بازیهایی بسیار آموزنده است؛ زیرا برتری در آنها حاصل طرحی منسجم، کنترل پوزیسیونی یا تبدیل صبورانهٔ برتری در آخر بازی است، نه منتظر ماندن برای لغزش ناگهانی یک الگوریتم تصادفی. این دیدگاه به شما میآموزد که چگونه برتریهای کوچک را گامبهگام افزایش دهید و در لحظات پرفشار بازی پوزیسیونی تعادل ذهنی خود را حفظ کنید.
حتی در آخر بازی نیز رفتاری انسانی دیده میشود. برنامههای قدیمی در موقعیتهای باخته با قربانیهای بیثمر مات را به تعویق میاندازند، اما Maia با سرسختی شاه خود را فعال میکند و در پی پیادهسازی پیادهٔ رونده برمیآید.
مسیر تکامل: از مدلهای نخست تا Maia-2 و Maia-3
دستاوردهای سال ۲۰۲۰ کارآمدی ایده را نشان داد، اما ساختار نخست محدودیتهایی داشت. هر سطح ریتینگ نیازمند شبکهای جداگانه بود: مدلهای ۱۱۰۰، ۱۲۰۰، ۱۵۰۰ و ۱۹۰۰ مستقل بودند و پیوستگی رشد مهارت را در یک مدل نشان نمیدادند.
گروه پژوهشی برای حل این مشکل در سال ۲۰۲۴ معماری یکپارچهٔ Maia-2 را بر پایهٔ سازوکارهای توجه در مدلهای ترنسفورمر معرفی کرد. Maia-2 با دریافت ریتینگ هدف در ورودی، امکان داد یک شبکهٔ عصبی واحد تمام طیف مهارت انسانی را پوشش دهد.
در گام بعدی، آزمایشگاه Computational Social Science Lab در دانشگاه تورنتو در سال ۲۰۲۵ مدل Maia-3 79M را عرضه کرد. این مدل ترنسفورمر با داشتن ۷۹ میلیون پارامتر و آموزش بر پایگاههای گستردهٔ حرکات انسانی، بازی پیشگیرانه، جابهجاییهای آخر بازی و درک پوزیسیونی را با ظرافتی بالاتر اجرا میکند و به فلسفهٔ بنیادین بازی شبیه انسان وفادار میماند.
پروژهٔ Maia-3 تحت مجوز آزاد GNU Affero General Public License نسخهٔ ۳٫۰ (AGPL 3.0) منتشر شده است تا پژوهشگران و جامعهٔ شطرنج جهان بتوانند آزادانه آن را بررسی کنند.
دستاورد پژوهشهای انسانمحور برای تمرین عملی شطرنج
یافتههای علمی پیرامون Maia نکتهای کلیدی را برای هر شطرنجباز علاقهمند به پیشرفت روشن میسازد: آمادگی برای رویارویی با حریفان واقعی مستلزم شناخت حرکتهایی است که انسانها واقعاً روی صفحه بازی میکنند، نه حفظ کردن شاخههای بیستحرکتی رایانهای که در بازیهای باشگاهی هرگز رخ نمیدهند.
وقتی بازیکنان در تحلیلهای خود تنها به پیشنهاد نخست موتورهای فراانسانی تکیه میکنند، اغلب واریانتهای پیچیدهای را به حافظه میسپارند که منطق راهبردی آنها را درک نکردهاند. به محض اینکه حریف در حرکت ششم با یک حرکت طبیعی اما غیرکتابی از شاخهٔ اصلی خارج شود، بازیکن بدون طرح و برنامه میماند. ترکیب تجربهٔ عملی بازی با مطالعهٔ هدفمند در درسهای شطرنج این خلأ را پر میکند و اصول بنیادینی همچون هماهنگی مهرهها، نبرد بر سر مرکز و الگوهای تاکتیکی را در ذهن تثبیت میسازد.
تمرکز بر تصمیمگیریهای واقعی انسانها هنگام تمرین، چه در حال آمادهسازی برای مسابقات باشید و چه در حال سنجش گشایشی تازه، به شما کمک میکند خطاهای رایج پوزیسیونی را بهتر بشناسید و شهودی پرورش دهید که پای صفحهٔ واقعی به کمکتان میآید.
پرسشهای متداول دربارهٔ Maia
آیا Maia قویتر از Stockfish است یا ضعیفتر؟
از نظر توان برد مطلق، Maia بهعمد ضعیفتر از Stockfish طراحی شده است. Stockfish در پی تصمیمات ریاضی بینقص است و برنده خواهد شد؛ درحالیکه هدف Maia ارائهٔ نمایی دقیق از شیوهٔ تفکر انسانها در ریتینگهای مختلف است.
آیا Maia اشتباهات تاکتیکی بزرگ مرتکب میشود؟
بله؛ چون دادههای آموزش از بازیهای بازیکنان واقعی از ریتینگ ۱۱۰۰ به بالا گردآوری شده، مدلهای ردههای پایینتر همان غفلتها و لغزشهای مألوف در مسابقات آماتور را نشان میدهند.
آیا Maia از کتاب گشایش و جدول آخر بازی استفاده میکند؟
برخلاف برنامههای سنتی که به میلیونها شاخهٔ آماده و جداول نالیموف وابستهاند، Maia حرکات را مستقیماً از شبکهٔ عصبی آموزشدیدهٔ خود میآفریند و تجربهٔ شهودی شطرنجبازان را منعکس میکند.
چرا بازی با رباتهای سایتهای دیگر عجیب به نظر میرسد؟
بیشتر سایتها موتوری فوقالعاده قوی را با روشهای ساختگی یا خطاهای تصادفی مهار میکنند. این تناقض میان حرکات بینقص و خطاهای مضحک ارزش آموزشی رقابت را از بین میبرد.
آیا Maia برای آمادگی در مسابقات حضوری مناسب است؟
بله، بهترین کاربرد آن دقیقاً همین است. چون Maia با سبک طبیعی انسان بازی میکند و اشتباهات پوزیسیونی آشنایی دارد، تمرین با آن ذهن شما را برای واکنشها و تهدیدهای حریفان روی صفحهٔ واقعی آماده میسازد.
منابع
- McIlroy-Young, R., Sen, S., Kleinberg, J., & Anderson, A. (2020). Aligning Superhuman AI with Human Behavior: Chess as a Model System. Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, 1677–1687.
- Tang, Z., Jiao, D., McIlroy-Young, R., Kleinberg, J., Sen, S., & Anderson, A. (2024). Maia-2: A Unified Model for Human-AI Alignment in Chess. arXiv preprint arXiv:2409.20553.
- CSSLab, University of Toronto. (2025). Maia-3 79M: Transformer model trained on human chess moves.
- Boardgammon. “Chess Moment: Play rated chess online.”
- Boardgammon. “Chess lessons and fundamentals.”
- Boardgammon. “Chess Moment: Play chess online.”
غلطی دیدید یا جملهای به گوشتان غریب آمد؟ به ما خبر بدهید